传统RAG
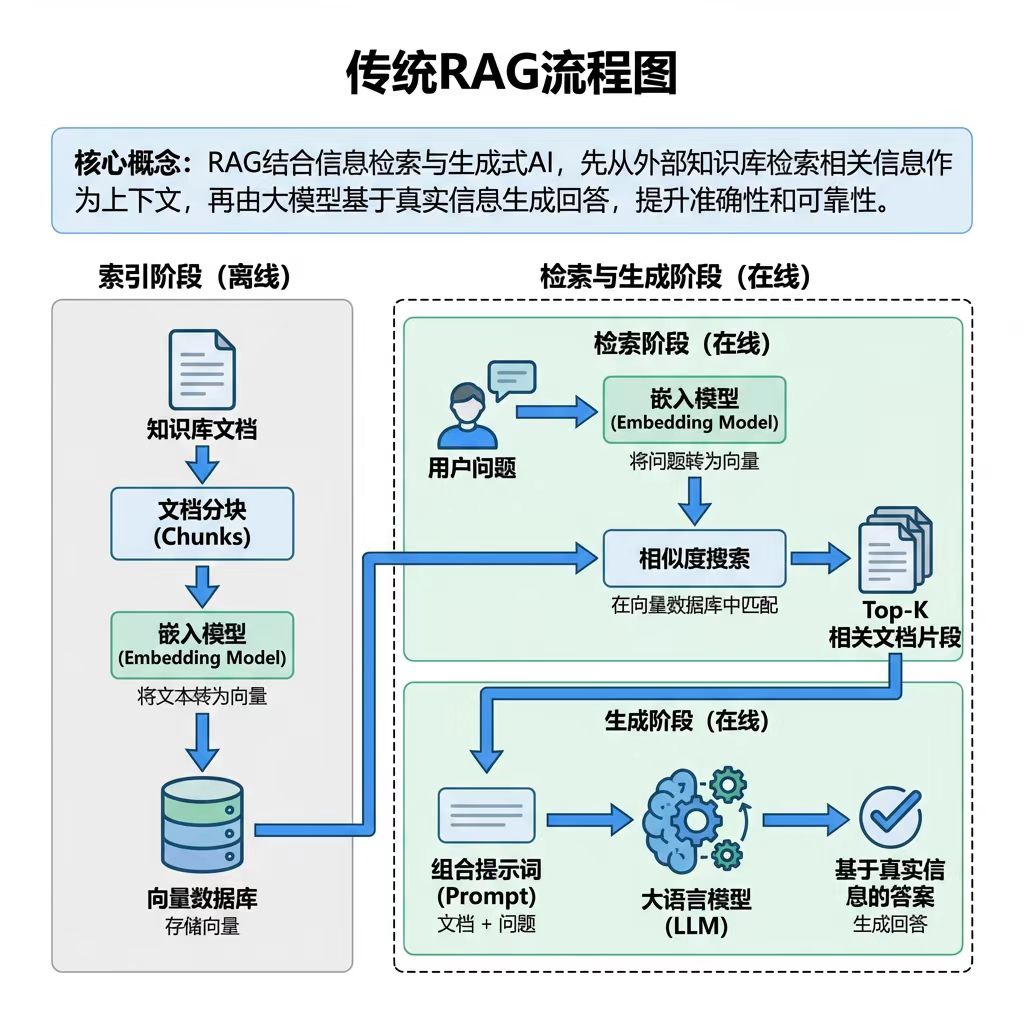
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合了信息检索和生成式AI的技术架构,用于提升大语言模型回答问题的准确性和可靠性。
核心概念
RAG 的基本思想是:在生成答案之前,先从外部知识库中检索相关信息,然后将检索到的内容作为上下文提供给语言模型,让模型基于这些真实信息生成回答。
基本流程
-
索引阶段(离线)
- 将知识库文档分块(chunks)
- 使用嵌入模型(Embedding Model)将文本转为向量
- 存储到向量数据库中
-
检索阶段(在线)
- 将用户问题转为向量
- 在向量数据库中进行相似度搜索
- 返回最相关的Top-K个文档片段
- 生成阶段(在线)
- 将检索到的文档和用户问题组合成提示词
- 输入到大模型
- 生成基于真实信息(文档)的答案
Agentic RAG
Agentic RAG 引入了 Agent 的概念,将传统 RAG 中"检索阶段 → 生成阶段"的线性流程替换为由 Agent 主导的动态决策过程,将文档检索以 tool 的形式赋予 Agent,由 Agent 自主决策如何检索、是否检索。
下面以一个例子展示 Agentic RAG 的优势:
传统 RAG:
用户问题:"2023年Q4销售额相比去年同期增长了多少?"

流程:
1. 检索 "2023 Q4 销售数据"
2. 返回相关文档
3. 生成答案(可能因缺少2022年数据而不完整)
Agentic RAG:
用户问题:"2023年Q4销售额相比去年同期增长了多少?"

流程:
1. Agent 分析:需要两个时间段的数据才能计算同比增长
2. 第一次检索:2023 Q4 销售数据
3. 第二次检索:2022 Q4 销售数据
4. 调用计算工具:计算同比增长率
5. 判断数据完整性
6. 如需要,进一步检索细分数据
7. 整合所有信息生成完整分析报告
显然,通过大模型自身的分析和检查以及多轮检索,大大提高了最终回答的准确性。
混合检索
虽然 Agentic RAG 显著提升了回答准确性,但在检索质量方面仍有优化空间。
在离线的索引阶段,我们将文档拆分为 chunk 之后,以向量的形式存入向量数据库。从向量数据库查询时,通常是匹配与查询向量最相关的 chunk(比如使用余弦相似度),这样的检索实际上是进行语义检索,并不一定要求 chunk 中含有整个查询,但是仅仅使用这样的检索可能会丢失更关键的精确匹配。
比如有下面这样的一个查询:
查询: "Python 3.9 新特性"
返回的 chunk 可能是这样: * "Python 3.9 引入了字典合并运算符" * "Python 3.8 的新功能介绍"
可以看出因为只匹配了 "Python 3.8 的新功能介绍" 与 "Python 3.9 新特性" 的语义相似度,导致返回了不相关的 chunk。
要解决这一问题,实际上我们需要对 "3.9" 这个关键词进行精确匹配。
这一问题可以通过使用 BM25(Best Matching 25)算法解决,BM25 是 TF-IDF 算法的改进版本,因此我们不妨先来看看 TF-IDF。
TF-IDF
TF-IDF 的核心思想是:如果一个词在一篇文章中出现很多,但在其他文章中出现很少,则认为该词最能代表这篇文章的主题。
1. TF (Term Frequency):词频
- 逻辑:一个词在文档里出现次数越多则对这篇文档越重要
- 计算公式: $$ TF(t, D) = \frac{词t在文档D中出现的次数}{文档D中的总词数} $$
2. IDF (Inverse Document Frequency):逆文档频率
- 逻辑:如果一个词在全库(Corpus)中所有的文档里都大量出现(比如"的"、"是"、"在"),那么这个词就没有区分度,不重要。相反,如果一个词只在极少数文档中出现(比如"量子纠缠"、"周杰伦"),它就具有很强的区分性,权重应该更高。
- 计算公式:
最终得分
将两者相乘得到某个关键词与某篇文档的相关性得分: $$ TF\text{-}IDF(t, D) = TF(t, D) \times IDF(t) $$
缺陷
TF-IDF 虽然一定程度上衡量了关键词在大量文档中的重要程度,但是还存在缺陷: * 线性增长问题:在 TF 中,一个出现 100 次的词的得分是出现 10 次的词得分的 10 倍,但是出现 100 次的文档的相关性真的是出现 10 次文档相关性的 10 倍吗?通常不会有这么高,当词频超过一定程度之后,其得分贡献应该趋于饱和。 * 对长文档偏见:虽然 TF 已经除以了文档总词数,但是极长文档还是更容易获利。
BM25 对上述问题进行了改进:
BM25
BM25 的公式本质上依然遵循 "相关性 = TF × IDF" 的基本逻辑,但它对 TF 和 IDF 进行了精细的改造。我们可以把 BM25 的公式拆解为三个模块来对比理解:
模块 1:IDF 部分(单词的权重)
TF-IDF 的逻辑: 越稀有的词,权重越高。 BM25 的改进: 公式略有不同,但核心逻辑一致。
- TF-IDF 的 IDF: \(\log \frac{N}{n(q)}\)
- BM25 的 IDF: \(\log \frac{N - n(q) + 0.5}{n(q) + 0.5}\)
为什么要改? BM25 的 IDF 计算方式更平滑。当一个词在超过半数的文档中出现时,传统 IDF 可能会变成负数,而 BM25 通过常数偏移(0.5)和结构调整,使其在高频词处理上更加稳定。
模块 2:TF 部分(词频饱和度)
这是 BM25 相比 TF-IDF 最大的进步。
- TF-IDF 的 TF: 是线性的。一个词出现的次数越多,得分就无上限地增加。
- BM25 的 TF: 是非线性的,引入了 "收益递减" 机制。
从公式中看:
\(\frac{f \cdot (k_1 + 1)}{f + K}\) (其中 \(f\) 是词频,\(K\) 是一个复杂的常数)。 * 当词频 \(f\) 增加时,得分无限趋近于 \(k_1 + 1\),但永远不会超过它。 * \(k_1\) 参数控制了"饱和的速度":\(k_1\) 越小,词频增加带来的收益越快达到上限。
模块 3:长度归一化(Length Normalization)
TF-IDF 对文档长度的处理比较简单(通常只是除以总词数),而 BM25 引入了"平均长度"作为参照物。
公式中的部分: \((1 - b + b \cdot \frac{|D|}{avgdl})\) * \(|D|\):当前文档的长度。 * \(avgdl\):整个语料库中所有文档的平均长度。 * \(b\):调节参数(通常 0.75)。
逻辑是这样的: 1. 如果你比平均长度长:公式的分母会变大,从而压低 TF 得分。因为长文章更有可能"碰巧"多次出现关键词。 2. 如果你比平均长度短:分母变小,从而放大 TF 得分。因为短文章能多次命中关键词,说明其主题相关性极高。
混合检索实现
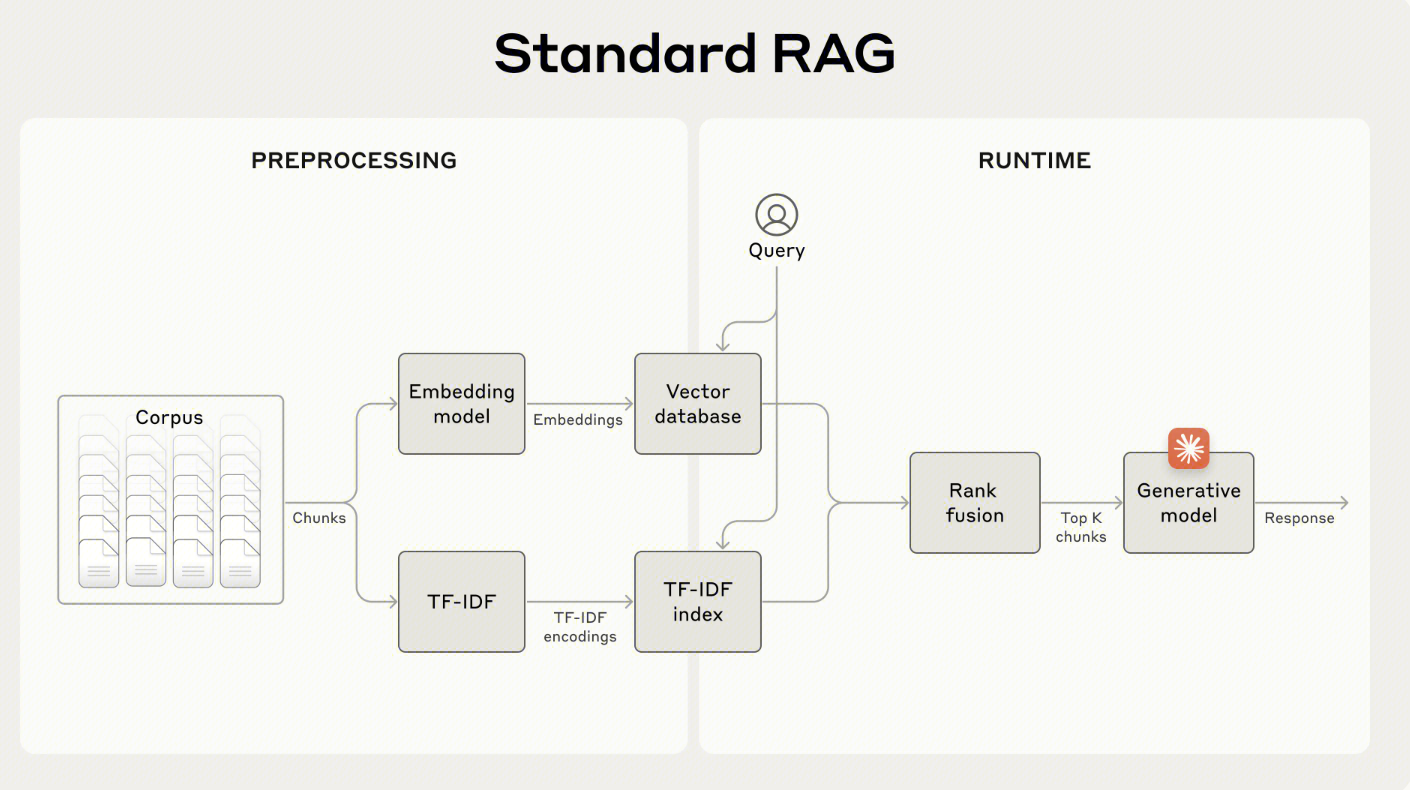
了解完 BM25 算法之后,我们回到 RAG 上来,通过混合向量检索以及 BM25 检索,我们可以综合得到既有语义相关性,又有关键词精确匹配的文档。
融合策略
在实际应用中,需要将向量检索和 BM25 检索的结果进行融合,常见方法包括:
1. 倒数排名融合(RRF, Reciprocal Rank Fusion) \(\(Score_{RRF} = \sum_{i} \frac{1}{k + rank_i}\)\) 其中 \(k\) 是常数(通常为 60),\(rank_i\) 是文档在第 \(i\) 个检索结果中的排名。
2. 加权融合 \(\(Score_{hybrid} = \alpha \cdot Score_{vector} + (1-\alpha) \cdot Score_{BM25}\)\) 其中 \(\alpha\) 是权重参数,需要根据实际场景调优。
结合 BM25 之后,RAG 的流程如下图所示:
上下文检索
在 RAG 中长文档通常会被拆分多个 chunk 存储,虽然提高了检索效率,但是这种做法可能会使得 chunk 丢失上下文带来更大的问题。
比如,假设有一份财务报告,其中一个片段写着:"该公司的营收增长了 20%。" - BM25 的困境:如果用户搜索"苹果公司 2023 年营收",这个片段里没有"苹果"也没有"2023",BM25 很难精准命中它。 - 向量检索的困境:虽然语义接近,但由于缺乏主语和背景,这个片段的向量表示会非常模糊。
什么是上下文检索
上下文检索可以有效缓解上述问题,其核心思想是:通过大模型为每个 chunk 加上一段解释或者背景介绍的上下文。
具体操作流程: 1. 输入:整个长文档 + 其中的一个片段。 2. 处理:让 LLM 生成一段简短的背景(例如 50-100 字),解释这个片段在全文中讲的是什么。 3. 合并:将"背景介绍"拼接到"原始片段"的前面。 4. 索引:对这个"增强后的片段"重新进行 BM25 索引或向量化处理。
举个例子:
原始片段:
"其销售额在第三季度达到了 50 亿美元,主要得益于新机型的发布。"
上下文检索处理后(增强片段):
[背景信息]:这篇文章是关于 苹果公司 2024 财年的季度财务分析。本段讨论的是其 iPhone 16 系列发布后的市场表现。 [原始内容]:"其销售额在第三季度达到了 50 亿美元,主要得益于新机型的发布。"
当用户搜索"iPhone 16 表现如何?"或者"苹果 2024 营收"时,BM25 能够轻松匹配到加粗部分的关键词,向量检索也能准确识别语义。
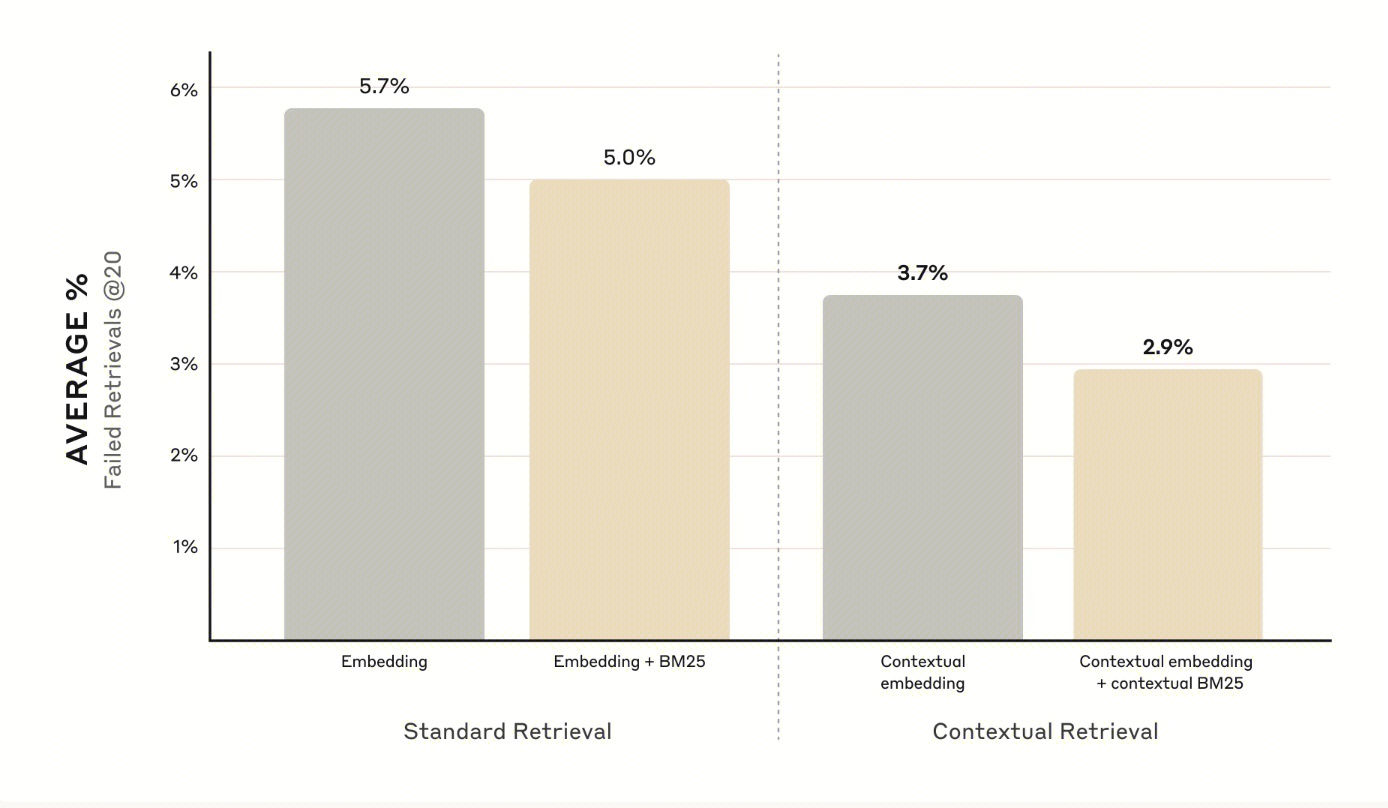
下图是 Anthropic 官方博客中的结果:
缺陷
虽然效果很好,但是成本也很高: * 每个 chunk 都要大模型生成上下文,计算成本高,当然这里可以使用便宜的小模型 * 存储上下文带来存储成本
重排
重排保证将最相关的内容传递给大模型,其核心流程是: * 初步检索相关的 chunk,比如检索最相关的 150 个 chunk * 将这 150 个 chunk 与用户的查询一并发送给重排(rerank)模型 * rerank 模型给出评分,根据评分选择比如前 20 个 chunk * 将这 20 个 chunk 发送给大模型,作为最终的检索结果
同样的,使用 rerank 模型带来了额外的成本和延迟,其中成本和更好效果之间的权衡需要找到一个平衡点。
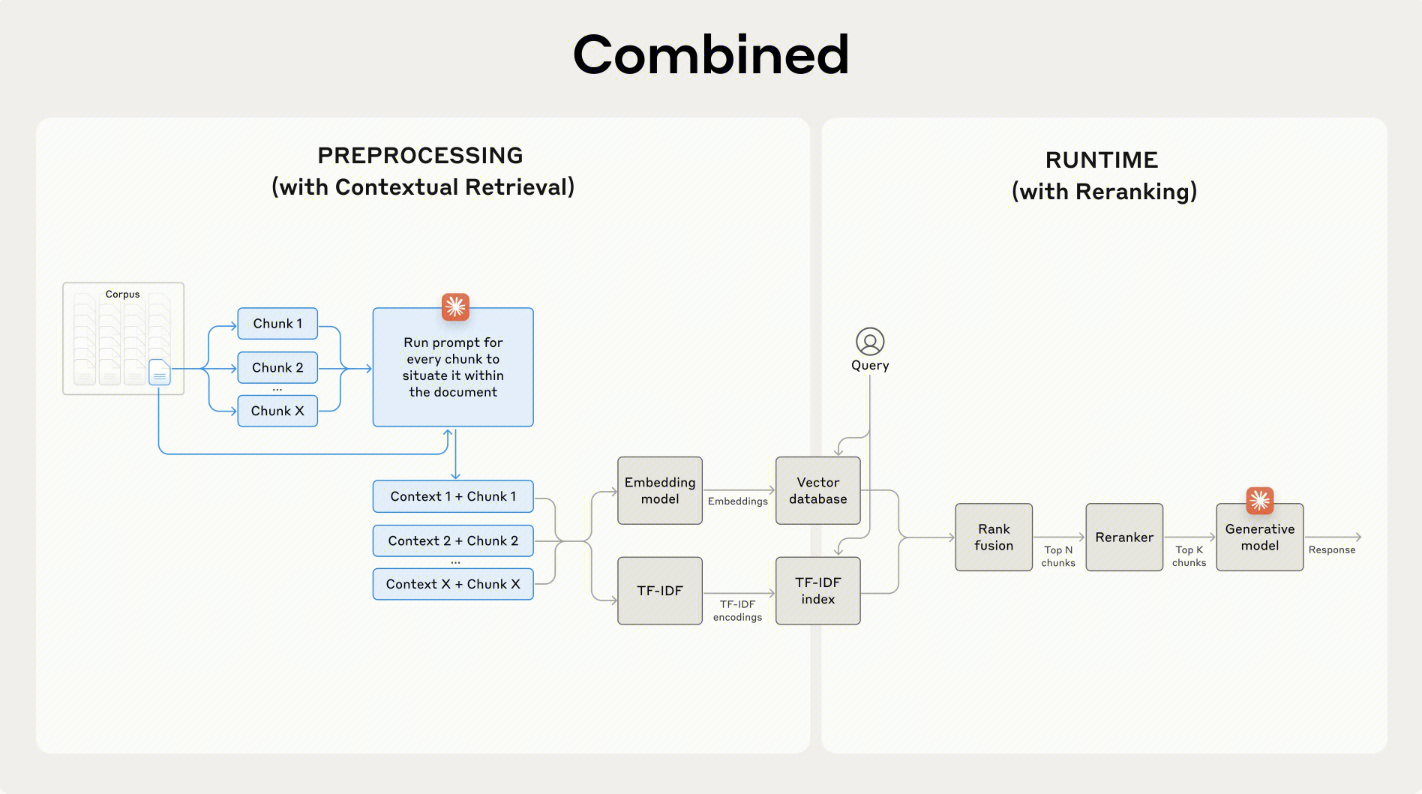
结合上下文检索和重排,最终 RAG 系统的流程为:
Discussion.