旧 Go Map 实现
在 Go 代码中使用的 map 数据结构实际会被编译为 runtime/map.go 中的 hmap 结构体。在 1.24.0 版本之前,hmap 结构体为:
type hmap struct {
    count     int            // map 中元素的个数
    flags     uint8          // 状态标志位(iterator、hashWriting、sameSizeGrow 等)
    B         uint8          // bucket 数量的对数,bucket 数量 = 2^B
    noverflow uint16         // overflow bucket 的近似数量
    hash0     uint32         // hash 种子,用于防止哈希攻击

    buckets    unsafe.Pointer // bucket 数组指针
    oldbuckets unsafe.Pointer // 扩容时旧的 bucket 数组
    nevacuate  uintptr        // 搬迁进度,小于这个值的 bucket 已搬迁完成

    extra *mapextra          // 可选字段
}
内存布局
从上面这个结构体可以看出来 Go map 的大致结构,本质来讲就是一个数组,只不过这个数组由哈希桶(bucket)来组成。将计算出的 hash 值取低 B 位即可从数组中索引到具体的 bucket。bucket 中存储了 8 个 key-value 对。除了 kv 对之外,每个 bucket 还存储了 tophash,即每个 key 的 hash 值的高 8 位。并且在 bucket 内,并不是按照 kv 对的顺序来存储,而是所有 tophash 存在一起,所有 key 存在一起,所有 value 存在一起。大概的内存布局如下:
内存地址
  +------------------+
  |  buckets 指针    |  --> h.buckets
  +------------------+
  |   bucket[0]      |
  |   tophash[8]     |
  |   keys[8]        |
  |   values[8]      |
  |   overflow *     |
  +------------------+
  |   bucket[1]      |
  |   tophash[8]     |
  |   keys[8]        |
  |   values[8]      |
  |   overflow *     |
  +------------------+
  |   ...            |
  +------------------+
  |   bucket[2^B-1]  |
  +------------------+
  |   预分配的       |
  |   overflow       |
  |   buckets        |
  +------------------+
这里可能会有两个疑惑:
-
为什么需要 tophash?
-
为什么 tophash 全放一起,key 全放一起,value 全放一起?
为什么需要 tophash:tophash 的主要作用是可以进行快速过滤,tophash 只是一个 uint8,相较于复杂的 key 值来说会小很多。大部分情况下只需要比对 tophash,如果不相同则直接跳过,只有少部分情况下 tophash 相同,那还需要比对 key 值。
为什么 tophash 全放一起,key 全放一起,value 全放一起:主要是为了减少 padding,例如 map[int64]int8 就不需要额外填充。
Hash 碰撞
当不同的 key 经过哈希函数的计算得到相同的 hash 值时就会产生哈希碰撞,旧版的 Go map 使用链式地址法处理哈希碰撞。当 hash 值的低 B 位相同时,会落到同一个 bucket,如果 bucket 满了(超过 8 个 kv 对),这时候会创建 overflow bucket(溢出桶),然后将上一个桶 overflow 指针指向溢出桶即可(链表)。大致结构如下:
bucket[0] -> overflow1 -> overflow2 -> overflow3 -> ...
扩容机制
Go map 扩容的触发条件为平均每个 bucket 中的 key-value 对超过 6.5 个时触发扩容(负载因子 = 元素总数 / bucket 数量 > 6.5)。每次扩容会增加一倍的 bucket,即创建一个新的 bucket 数组且 B++(bucket 的数量为 2^B)。创建之后,Go map 并不是一次性将旧的 bucket 数组中的 key-value 对搬迁到新 bucket 数组,而是采用渐进式搬迁。将搬迁工作均匀到后续的每次访问、插入、删除元素中,每次操作只搬迁 1~2 个 bucket,从而避免单次操作卡顿。
旧 Go Map 的痛点
主要痛点有:
- 溢出桶链表导致性能退化
- 查询效率低,需要逐个比较 tophash
新 Go Map 实现
内存布局
新 Go map 主要使用了 Swiss Table。Swiss Table 由多个 group 组成(类似于旧版中的 bucket),每个 group 中由一个 ctrlGroup 和 8 个 slot 组成。metadata 共有 8 个字节,称为控制字节(ctrl byte),与每个 slot 对应。每个 slot 存储具体的 key-value 对。如下图所示:
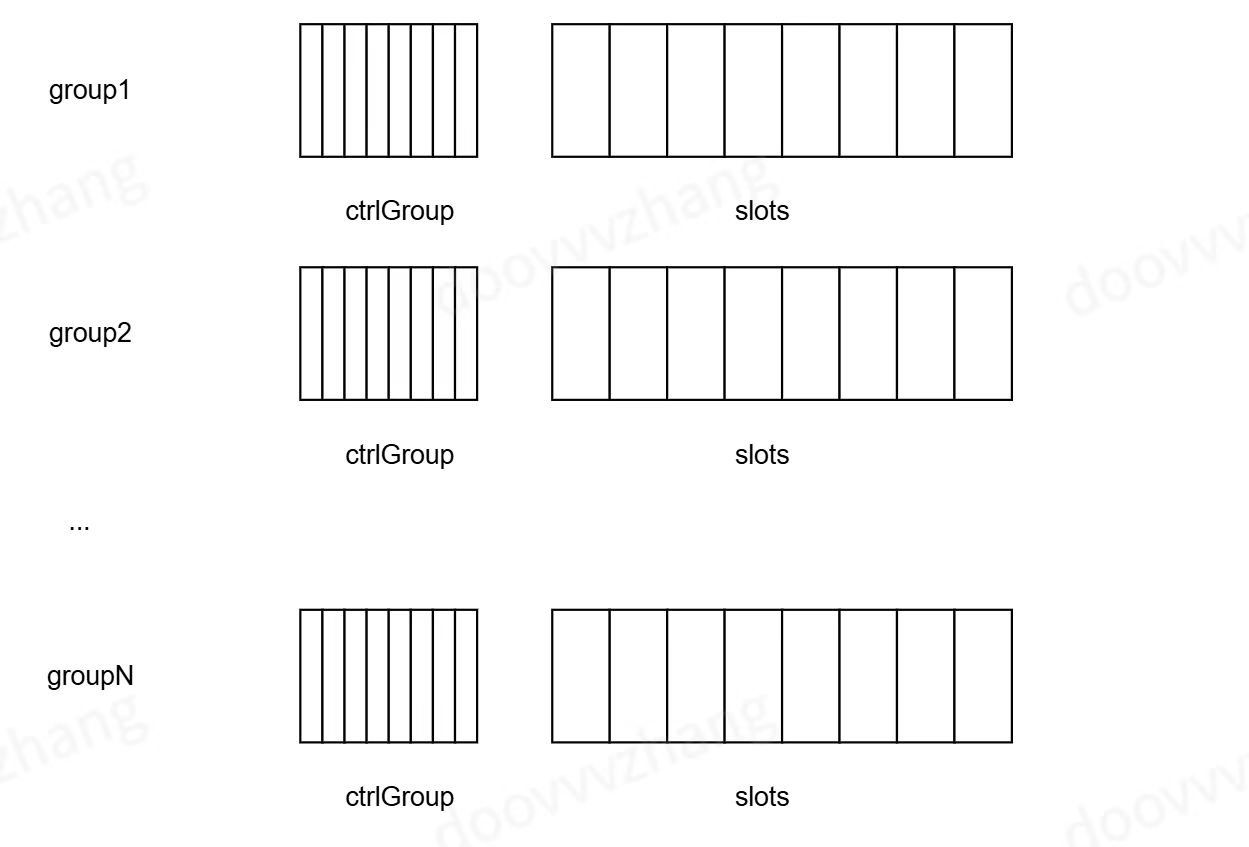
当向 Swiss Table 插入或者查询一个 key-value 对时,首先通过哈希函数对 key 求值得到一个 64 位的哈希值,在 Go Swiss Table 中,这个哈希值被分为了两部分:
- H1:高 57 位
- H2:低 7 位
H2 被存在控制字节的低 7 位中,类似旧版中的 tophash,即插入或查询元素时首先匹配 H2,如果匹配成功再去匹配完整的 key。注意 H2 实际只有 7 位,因此控制字节还有最高位可以用来表示其他状态,只有当最高位为 0 时才代表当前 slot 被使用了,如下:
- empty:
1000 0000 (0x80),表示 slot 未被使用 - deleted:
1111 1110 (0xFE),表示 slot 的元素已经被删除 - full:
0hhh hhhh(h 是 7 位 H2 哈希位),表示该 slot 正在被使用
快速匹配
ctrlGroup 由 8 个控制字节组成,可以用 uint64 表示,因此在查找对应元素的时候可以使用位运算加快效率,一次性完成 8 个元素的对比。这就是性能提升的主要改进。除此之外,使用 SIMD 指令还可以一次性对比更多的元素。感兴趣的可以了解一下这里位运算的计算细节,源码如下:
bitsetLSB     = 0x0101010101010101
bitsetMSB     = 0x8080808080808080

func ctrlGroupMatchH2(g ctrlGroup, h uintptr) bitset {
    // NB: This generic matching routine produces false positive matches when
    // h is 2^N and the control bytes have a seq of 2^N followed by 2^N+1. For
    // example: if ctrls==0x0302 and h=02, we'll compute v as 0x0100. When we
    // subtract off 0x0101 the first 2 bytes we'll become 0xffff and both be
    // considered matches of h. The false positive matches are not a problem,
    // just a rare inefficiency. Note that they only occur if there is a real
    // match and never occur on ctrlEmpty, or ctrlDeleted. The subsequent key
    // comparisons ensure that there is no correctness issue.
    v := uint64(g) ^ (bitsetLSB * uint64(h))
    return bitset(((v - bitsetLSB) &^ v) & bitsetMSB)
}
Hash 碰撞
新版 Go Map 使用开放寻址法中的平方探测法处理哈希碰撞。平方探测的探测序列为:h(k, i) = (h(k) + i²) mod m,其中 i 为探测次数。具体来说,如果当前 group 未命中时,使用平方探测法寻找下一个 group,直到探测到一个空的 slot。如果是访问元素,那么当访问到空 slot 时则可以返回未匹配了,如果是插入元素,则就将新元素插入到该 slot。
这样的设计也使得删除元素时不能直接删除,而是通过控制字节将该 slot 标记为删除。具体原因可以看下面这个例子:
假设探测的顺序是 group1 -> group2 -> group3,元素 X、Y 的 hash 值相同,X 在 group2 中,Y 在 group3 中,产生了以下操作:
- 删除 X,group2 中 X 的 slot 被标记为空
- 查询 Y,遍历到 group2 时就发现了空 slot,则返回认为 Y 不存在
通过上面这个例子可以看出删除元素时不能直接标记 slot 为空。
扩容机制
在扩容时如果直接对 group 数组进行翻倍,那么所有元素都需要进行 rehash,对于大型 map 来说会带来明显的延迟。因此新版 Go map 在 map 和 swiss table 之间新加了一层 directory,一个 directory 是一个 table 的数组,管理多个 table,整体结构如下:
Map (顶层)
 └── Directory (目录,可扩展哈希)
      └── Table (表,Swiss Table 实现)
           └── Groups (组,每组 8 个槽位)
                └── Slots (槽位,存储 key/value)
directory 采用可扩展哈希的设计,具体来说,directory 总共含有 2^globalDepth 个 table,根据 hash 值的前 globalDepth 个 bit 位来映射到具体 table,当某个 table 需要扩容时,会将该 table 分裂成两个 table,然后 globalDepth+1。
举个例子:
初始时 globalDepth = 1:
Directory (globalDepth=1)
+----+
| 0  | ------> table1 (localDepth=1)
+----+
| 1  | ------> table2 (localDepth=1)
+----+
后面由于 table2 满了发生了分裂,则 globalDepth+1:
Directory (globalDepth=2)
+----+
| 00 | --\
+----+    +--> table1 (localDepth=1)
| 01 | --/
+----+
| 10 | ------> table2 (localDepth=2)
+----+
| 11 | ------> table3 (localDepth=2)
+----+
这样设计的优点:
- 增量扩容:通过每次只扩容一个 table,避免大 map 的长时间停顿
- 灵活性:不同 table 可以有不同的负载因子,独立增长
性能
根据测试,Go 官方团队宣称查询(对于 Key 较多的情况)、增加与遍历性能都有 10~60% 的提升,用于测试的应用程序整体运行性能有 1.5% 的提升。
新旧实现对比
| 特性 | 旧实现(链式哈希) | 新实现(Swiss Table) |
|---|---|---|
| 碰撞处理 | 链式地址法(overflow bucket) | 开放寻址法(平方探测) |
| 元数据存储 | tophash (8 bit) | 控制字节 (8 bit,含状态位) |
| 查找效率 | 逐个比较,O(n) 最坏情况 | 位运算并行比较 8 个元素 |
| SIMD 支持 | 无 | 支持,可进一步加速 |
| 扩容策略 | 整体翻倍 + 渐进式搬迁 | Directory 分层 + 增量扩容 |
| 内存局部性 | 较差(链表跳转) | 较好(连续内存) |
| 性能提升 | - | 查询/插入/遍历 10~60% |
总结
Go 1.24 引入的 Swiss Table 实现是对 map 性能的重大改进。通过以下几个关键技术:
- 位运算并行匹配:利用控制字节和位运算,一次性比较 8 个元素
- 开放寻址:提高内存局部性,减少指针跳转
- 分层扩容:通过 Directory 层实现增量扩容,避免大 map 的长时间停顿
- SIMD 优化:在支持的平台上可以进一步提升性能
这些改进使得 Go map 在保持简洁 API 的同时,获得了显著的性能提升,特别是在大规模数据场景下表现更加出色。
Discussion.